Chuyển PDF sang Text: Trích xuất văn bản thuần từ mọi tệp PDF
Chuyển PDF sang Text lấy toàn bộ chữ trong tệp PDF của bạn và lưu thành một tệp .txt đơn giản. Mọi thứ chạy ngay trong trình duyệt, nên tài liệu vẫn nằm trên máy tính hoặc điện thoại của bạn.
Chuyển đổi ngay trên thiết bị này. Tệp của bạn không bao giờ được tải lên máy chủ.
Cách hoạt động
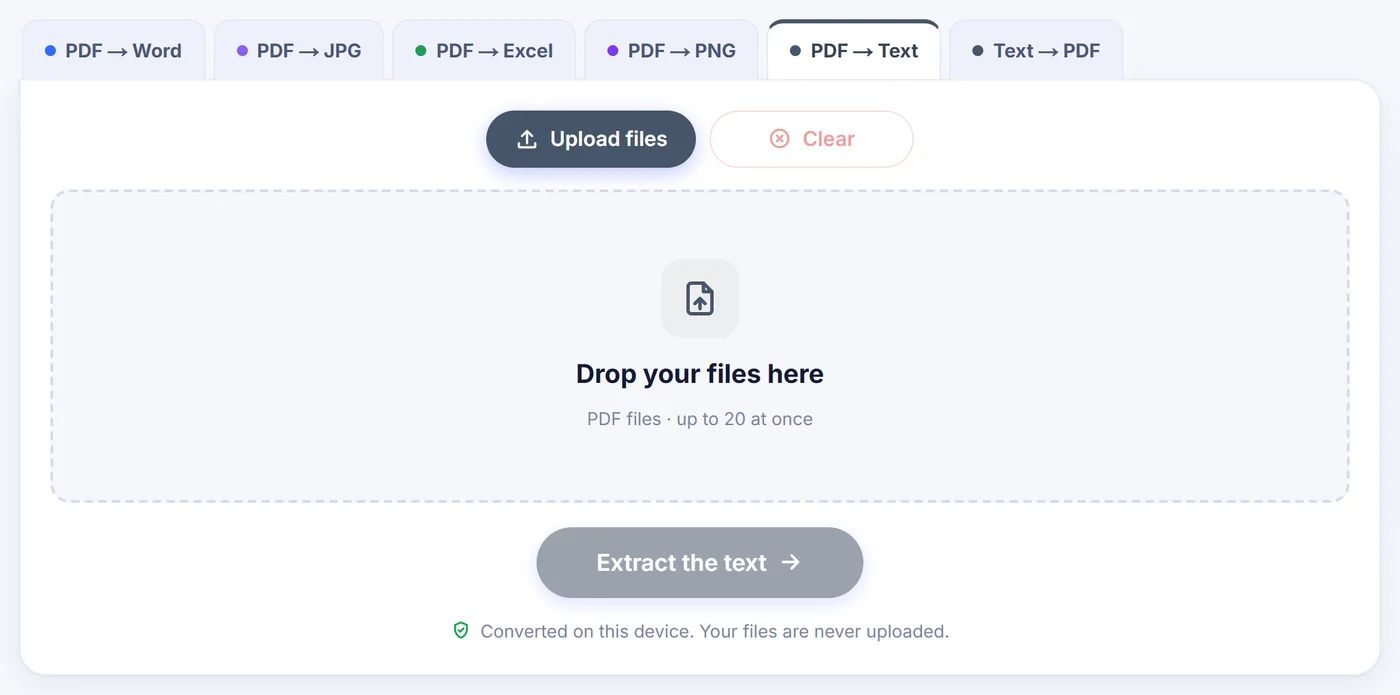
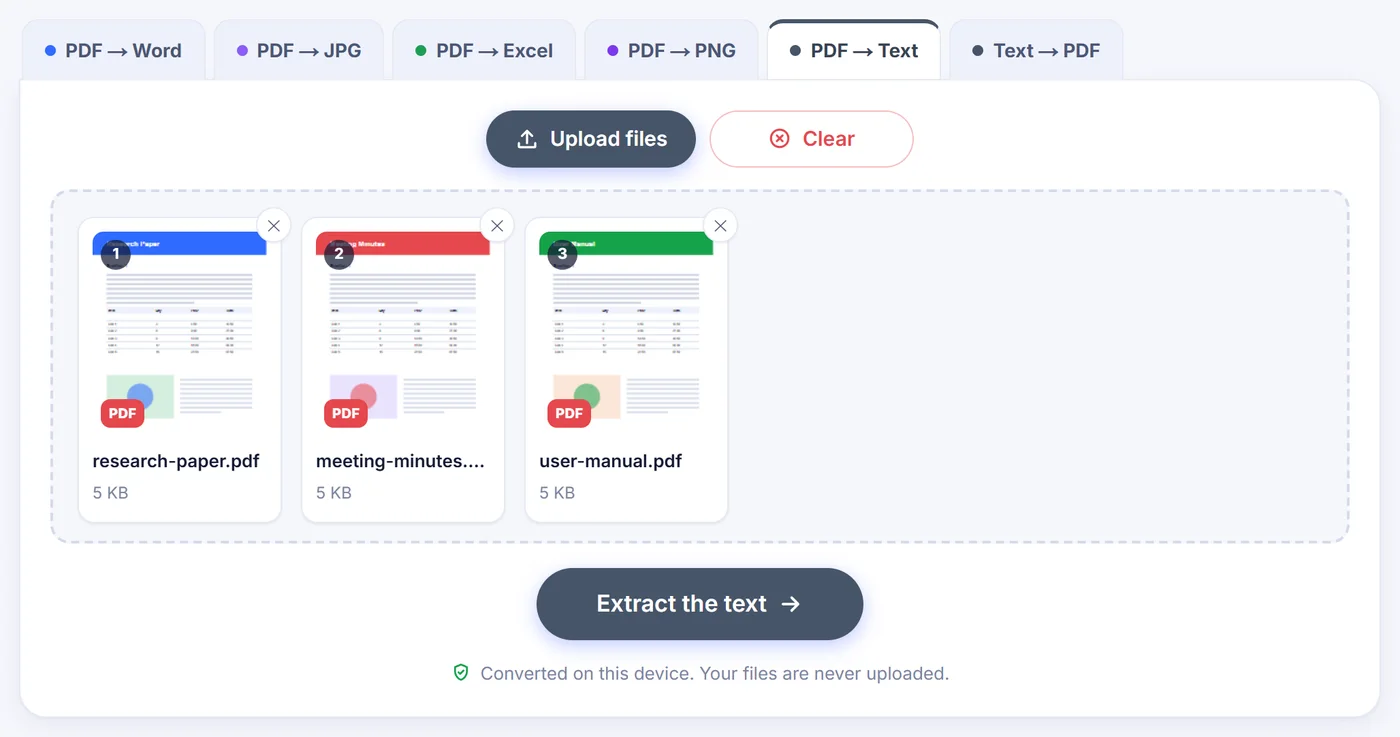
Thả một hoặc nhiều tệp PDF
Thêm tối đa 20 tệp; PDF có khóa sẽ hỏi mật khẩu ngay, và mật khẩu đó chỉ được dùng trên máy của bạn.
Chọn kiểu văn bản
Đoạn văn thuần, từng dòng hoặc giữ bố cục, cùng chế độ OCR, ngôn ngữ của các trang scan và, với một tệp PDF duy nhất, khoảng trang cần lấy.
Kiểm tra, sao chép hoặc lưu
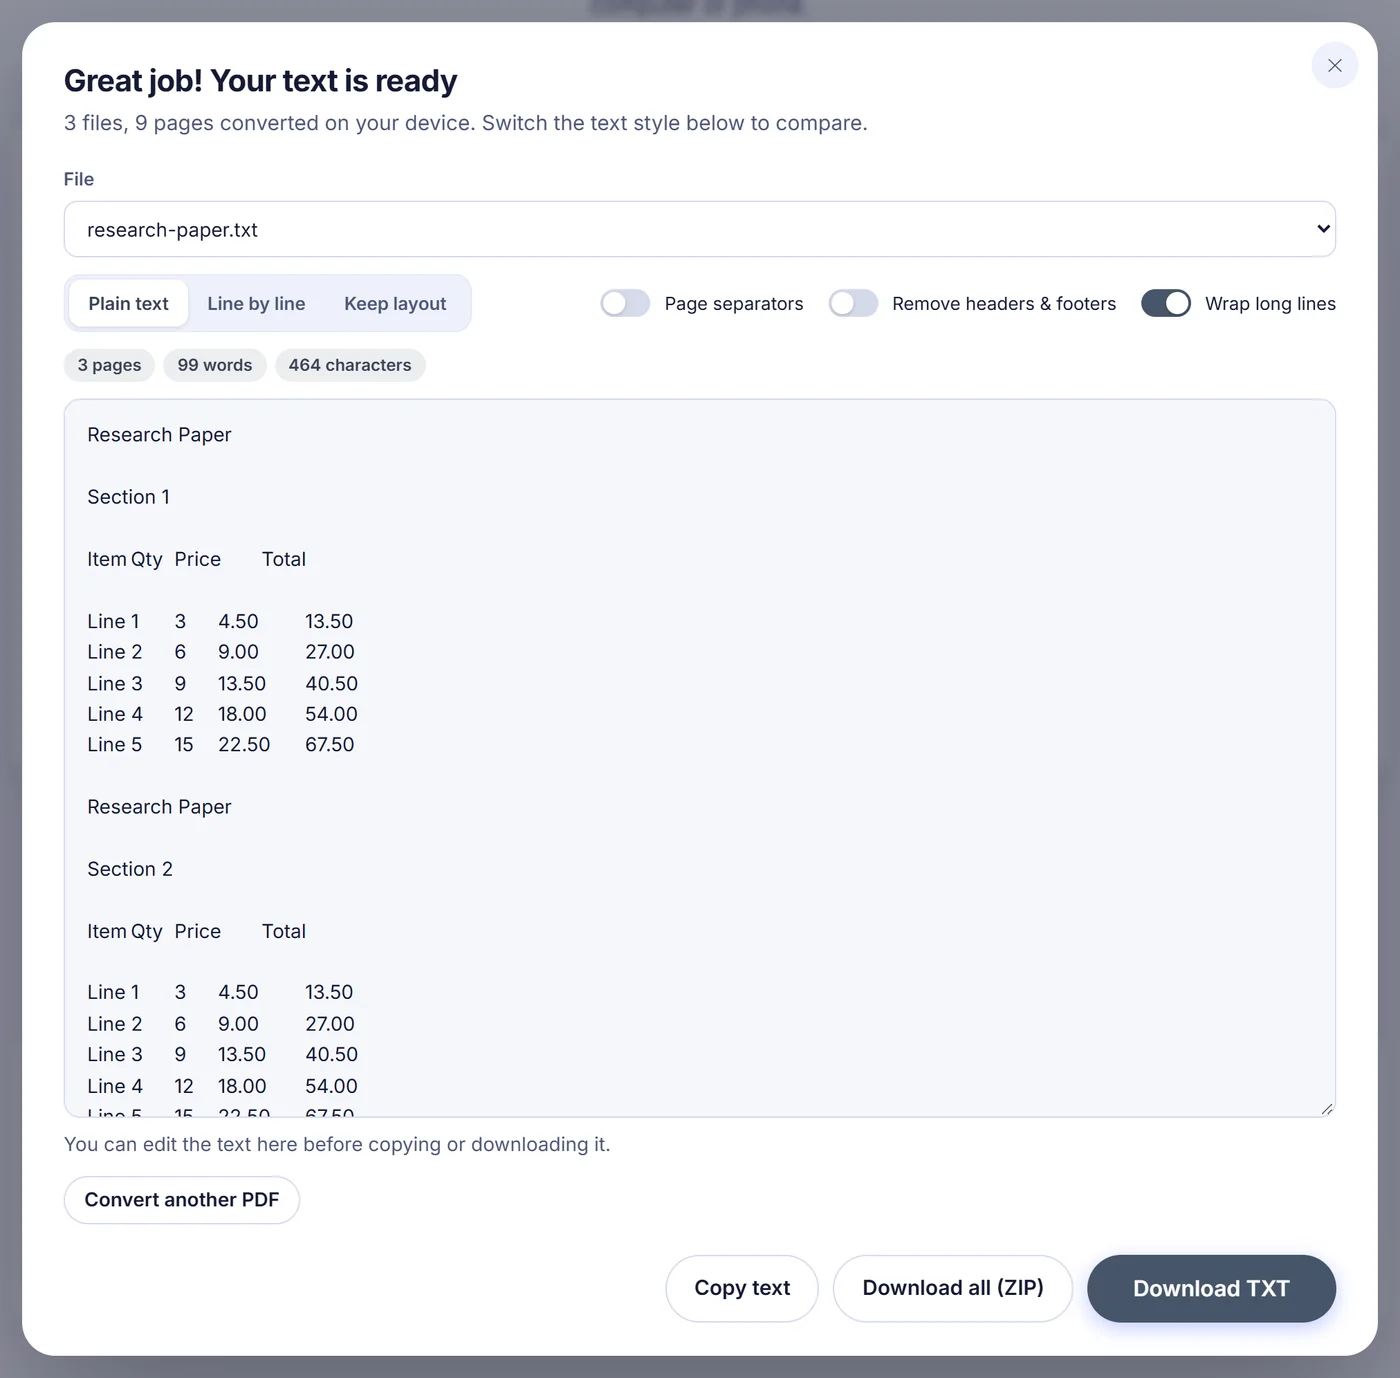
Đọc kết quả trong khung xem trước, sửa tay nếu cần, rồi sao chép hoặc lưu thành .txt; với nhiều tệp, bạn có thể tải tất cả trong một tệp ZIP.
Vì sao nên chuyển PDF thành văn bản thuần?
PDF được tạo ra để hiển thị giống nhau ở mọi nơi, chứ không phải để tái sử dụng. Thử sao chép một báo cáo dài từ trình xem PDF, bạn thường nhận được các dòng bị ngắt lung tung, từ bị cắt đôi bởi dấu gạch nối, số trang chen giữa câu và hai cột trộn vào nhau thành vô nghĩa. Tệp .txt thuần thì ngược lại: không phông chữ, không bố cục, chỉ có ký tự mà bất kỳ trình soạn thảo, script, công cụ tìm kiếm hay chatbot nào cũng đọc được.
Người ta tìm đến công cụ chuyển PDF sang Text khi muốn trích dẫn một đoạn, đưa hợp đồng vào công cụ dịch, dán bài nghiên cứu vào ứng dụng ghi chú, đếm số từ của bản thảo, tìm kiếm trong cả chồng hóa đơn hoặc cung cấp nội dung tài liệu cho một mô hình ngôn ngữ mà không kèm theo nhiễu. Tệp văn bản rất nhẹ, mở tức thì và dùng được với những phần mềm không bao giờ hiểu PDF.
Công cụ chuyển PDF sang Text này đọc tệp của bạn như thế nào
Công cụ không đơn giản đổ ký tự ra theo thứ tự chúng được lưu bên trong PDF, vốn thường rất lộn xộn. Nó xem vị trí thực của từng mẩu văn bản trên trang và dựng lại các dòng từ đó. Sau đó nó tìm dải trống theo chiều dọc giữa các cột. Khi trang được dàn thành hai hay ba cột, như bài báo khoa học hoặc bản tin, cột trái được đọc hết trước rồi mới đến cột phải, còn tiêu đề trải hết chiều ngang vẫn ở đúng chỗ. (Kiểu Giữ bố cục là ngoại lệ: nó tái hiện trang đúng như hình dạng vốn có, nên các cột vẫn nằm cạnh nhau.)
Một số PDF tạo chữ đậm bằng cách in cùng một từ hai lần, lệch nhau một chút. Những bản trùng này được loại bỏ, nên bạn sẽ không gặp "Tiêu đềTiêu đề". Những trang có chữ nằm ngang, chẳng hạn bảng khổ ngang bị xoay trên trang dọc, được xoay lại để hướng đọc chính trở thành nằm ngang.
Ba kiểu văn bản từ một lần đọc
- Văn bản thuần (khuyên dùng): các dòng được nối thành đoạn văn thật, tự dàn lại trong mọi trình soạn thảo. Từ bị tách qua hai dòng, như "ví-" và "dụ", trở lại thành "ví dụ". Trừ khi bật dấu phân cách trang, câu kéo dài sang trang sau cũng được nối lại.
- Từng dòng: giữ nguyên mọi dấu ngắt dòng trong PDF. Tiện cho thơ, mã nguồn, địa chỉ hoặc bất cứ thứ gì mà dòng có ý nghĩa.
- Giữ bố cục: văn bản được đệm bằng khoảng trắng để, với phông chữ đơn cách, các cột bảng và ô biểu mẫu vẫn thẳng hàng.
Cả ba kiểu được tạo từ cùng một lần đọc tệp, nên chuyển qua lại trong khung xem trước là tức thì và PDF không bị xử lý lại. Tuy nhiên việc chuyển kiểu sẽ xóa những gì bạn đã sửa trong khung xem trước, nên hãy chọn kiểu trước. Những hàng trông giống bảng sẽ giữ các ô tách nhau bằng ký tự tab ở hai kiểu đầu, giúp dán vào bảng tính rất dễ.
PDF scan và OCR
Bản scan chỉ là hình chụp của trang giấy, nên không có chữ để lấy ra. Khi bạn mở một tệp PDF, cửa sổ tùy chọn sẽ đếm những trang có chữ chọn được và cảnh báo nếu một số trang có vẻ là scan. Thiết lập OCR có ba lựa chọn. Auto (tự động) chỉ đọc những trang gần như không có chữ nhưng có chứa hình. Off (tắt) giữ đúng lớp văn bản sẵn có. Every page (mọi trang) bỏ qua lớp văn bản và đọc toàn bộ trang như hình ảnh, đây là cách khắc phục khi chữ sao chép ra thành ký tự vô nghĩa do mã hóa phông chữ bị hỏng.
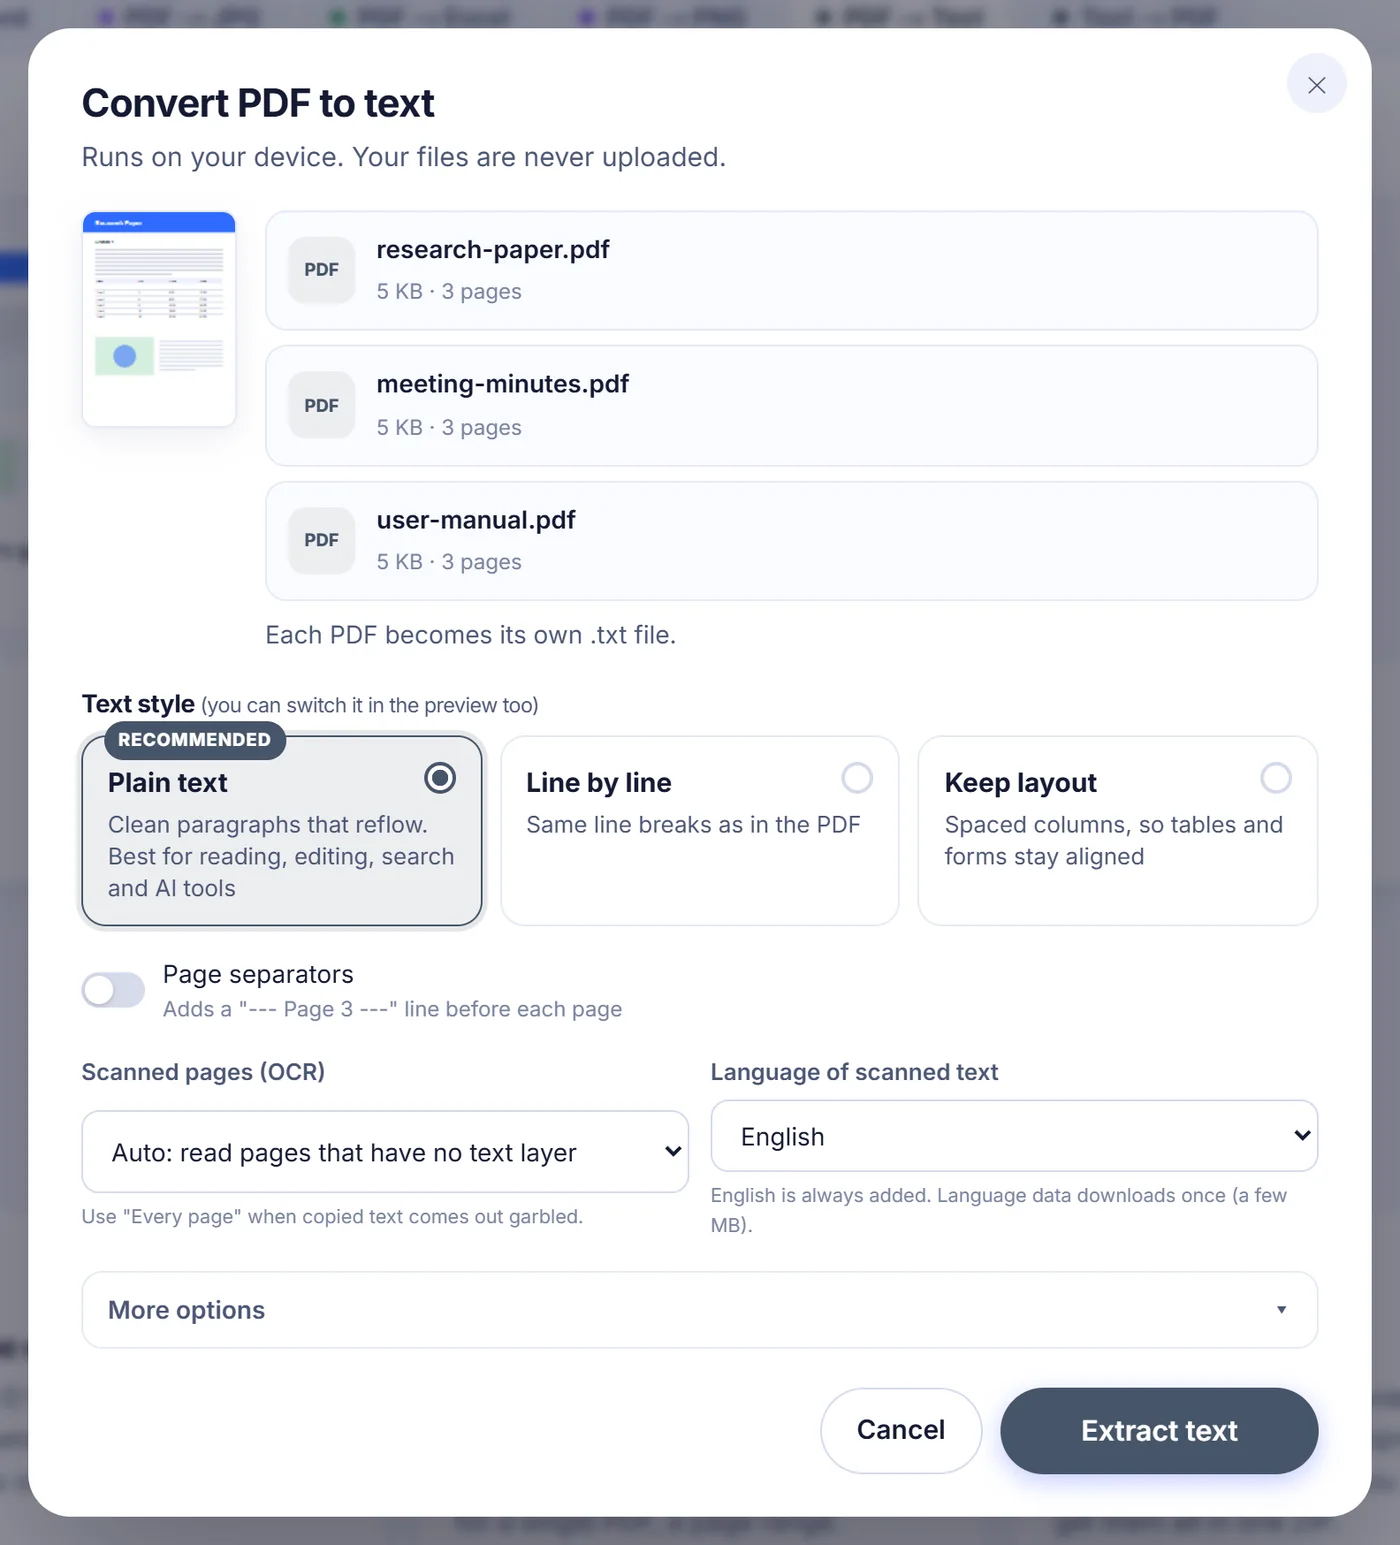
OCR chạy trên thiết bị của bạn bằng Tesseract. Hãy chọn ngôn ngữ của tài liệu trong hơn ba mươi lựa chọn, gồm tiếng Rumani, Đức, Pháp, Tây Ban Nha, Nga, Hy Lạp, Ả Rập, Do Thái, Hindi, Trung, Nhật và Hàn; tiếng Anh luôn được thêm vào để dự phòng. Dữ liệu ngôn ngữ chỉ tải về một lần (vài megabyte) và chỉ lần đầu đó mới cần kết nối internet. Sau khi xong, phần tóm tắt cho biết bao nhiêu trang được đọc bằng OCR và độ tin cậy nhận dạng trung bình, một cách nhanh để biết bản scan mờ có cần kiểm tra lại hay không.
Những tùy chọn đáng biết
- Pages (trang): với một tệp, bạn có thể gõ khoảng trang như 1-3, 8, 10- để chỉ trích xuất những trang đó. "10-" nghĩa là từ trang 10 đến hết.
- Page separators (dấu phân cách trang): chèn dòng "--- Page 3 ---" trước mỗi trang, hữu ích khi sau này bạn cần dẫn số trang.
- Remove repeating headers, footers and page numbers (bỏ đầu trang, chân trang và số trang lặp lại): những dòng xuất hiện lặp đi lặp lại ở đầu hoặc cuối hầu hết các trang (tên báo cáo, "Page 4 of 20", ghi chú bảo mật) sẽ bị loại. Cần ít nhất ba trang để so sánh.
- Hyphen joining (nối từ gạch nối): mặc định bật cho văn bản thuần; hãy tắt nếu tài liệu có những từ ghép bằng gạch nối thật ở cuối dòng cần giữ nguyên.
- Line endings and BOM (ký tự xuống dòng và BOM): chọn LF hoặc CRLF, và thêm dấu thứ tự byte UTF-8 nếu một chương trình Windows cũ hiển thị chữ có dấu thành ký hiệu lạ.
Các lựa chọn của bạn được ghi nhớ trong trình duyệt này cho lần truy cập sau.
Nhiều tệp PDF cùng lúc
Thêm tối đa 20 tệp trong một lần. Mỗi PDF trở thành một tệp .txt riêng mang tên bản gốc, nên bien-ban.pdf thành bien-ban.txt; hai tệp trùng tên sẽ được đánh số thêm. Trong cửa sổ kết quả, bộ chọn tệp cho phép xem từng văn bản riêng, và Download all (ZIP) gói tất cả .txt vào một tệp nén. Ô khoảng trang chỉ hiện khi chuyển đổi một tệp PDF duy nhất; với nhiều tệp, mọi trang của mọi tệp đều được đọc.
Kiểm tra và chỉnh sửa kết quả
Văn bản hiện trong một khung lớn kèm số trang, số từ và số ký tự cập nhật trực tiếp. Bạn có thể sửa ngay tại đó một cái tên bị đọc sai, xóa một đoạn miễn trừ trách nhiệm hay chỉnh gọn tiêu đề, rồi sao chép toàn bộ vào bộ nhớ tạm hoặc tải xuống. Tài liệu rất dài chỉ hiển thị hai triệu ký tự đầu ở chế độ xem trước chỉ đọc, nhưng sao chép và tải xuống luôn gồm đủ toàn bộ văn bản.
Sự cố thường gặp và cách xử lý nhanh
- "No text found" (không tìm thấy văn bản): các trang có lẽ là bản scan trong khi OCR đang tắt, hoặc chữ được vẽ bằng hình vector. Thông báo có kèm nút chạy lại tệp đó với OCR.
- PDF có mật khẩu: nhập mật khẩu khi được hỏi, hoặc bỏ qua tệp đó và tiếp tục với các tệp còn lại.
- Tệp bị hỏng: các trang không đọc được sẽ bị bỏ qua và được đếm trong ghi chú dưới văn bản, thay vì làm dừng cả tài liệu.
- Điện thoại hết bộ nhớ: hãy chuyển đổi một khoảng trang nhỏ hơn. OCR kết xuất trang ở khoảng 250 DPI nhưng giới hạn kích thước ảnh để trình duyệt di động chịu tải tốt hơn.
- Chữ viết tay: OCR được thiết kế cho chữ in; ghi chú viết tay hiếm khi cho kết quả dùng được.
PDF của bạn không bao giờ rời khỏi trang này
Việc đọc, nhận diện cột và OCR đều diễn ra bằng JavaScript và WebAssembly ngay trong tab trình duyệt của bạn. PDF không được gửi đi đâu cả, nên không có bản sao nào nằm chờ trên máy chủ để phải xóa. Khi bạn đóng tab, tệp và văn bản đã trích xuất đều biến mất. Công cụ miễn phí, không cần tài khoản hay email, và không chèn thêm gì vào văn bản của bạn.
Câu hỏi thường gặp
Làm sao chuyển PDF sang tệp TXT miễn phí?
Thả tệp PDF vào trang này, chọn kiểu văn bản và bấm nút. Bạn có thể sao chép kết quả hoặc tải về dưới dạng tệp .txt, không cần tài khoản và không có watermark.
Có trích xuất được văn bản từ PDF scan không?
Có. Khi OCR ở chế độ Auto, những trang chỉ là hình ảnh sẽ được Tesseract đọc ngay trên thiết bị của bạn. Hãy chọn ngôn ngữ của bản scan để chính xác hơn; tiếng Anh luôn được kèm theo.
Vì sao chữ sao chép từ PDF của tôi bị lỗi ký tự?
PDF đó có lẽ dùng phông chữ không có bảng ánh xạ ký tự đúng. Hãy đặt OCR thành "Every page" để các trang được đọc như hình ảnh thay vì tin vào lớp văn bản bị hỏng.
Công cụ có giữ bảng và cột không?
Ở kiểu văn bản thuần và từng dòng, trang nhiều cột được đọc theo từng cột và các ô bảng được tách bằng tab. Nếu muốn bảng hiển thị thẳng hàng, hãy chọn "Keep layout", kiểu này căn cột bằng khoảng trắng.
Có thể chỉ chuyển một số trang của PDF sang text không?
Có, khi bạn chuyển đổi một tệp: gõ khoảng trang như 2-5, 9 vào ô Pages. Với nhiều tệp, toàn bộ trang sẽ được trích xuất.
Chuyển đổi PDF bảo mật ở đây có an toàn không?
Tệp được xử lý ngay trong trình duyệt của bạn và không bao giờ gửi lên máy chủ. Mật khẩu của PDF có khóa chỉ dùng trên thiết bị của bạn và không được lưu lại.